문서의, 문서를 위한, 문서에 의한 웹
2019년 대니얼 야누스(Daniel Janus)가 쓴 에세이 「문서의 웹」(Web of Documents)은 웹이 복잡한 애플리케이션으로 변모해가는 과정에서 상실한 ‘문서’로서의 가치를 재조명한다.
1960년, 테드 넬슨(Ted Nelson)은 문서의 웹을 구상했다.
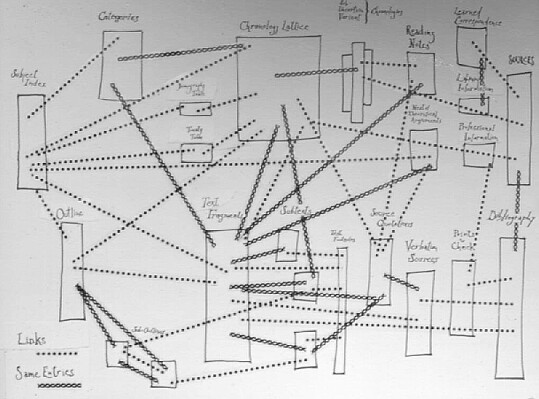
그것은 ‘제너두’(Xanadu)로 불렸다. 그 구상은 거대하고 전체론적인 비전이었다. 한번 게시된 문서는 영원히 유효하고, 양방향 하이퍼링크는 문서 전체뿐 아니라 일부분까지도 서로 연결시킬 수 있으며, 저작권과 로열티까지 관리되는 시스템. 제너두는 복잡했다. 그리고 끝내 실현되지 못했다.
하지만 31년 뒤 또 다른 ‘문서의 웹’이 이륙했다. 자나두보다 훨씬 소박한 프로젝트였다. 단순한 마크업 언어, 문서를 가져오기 위한 단순한 프로토콜, 단방향 하이퍼링크, 그리고 ‘하이퍼링크 부패’(link rot)를 막지 못하는 구조. 그 외에는 별다른 기능이 없는 것. 바로 월드 와이드 웹(World Wide Web, 웹)이다. 한 남자가 몇 달 만에 프로토타입을 만들었고, 그 뒤 폭발적인 인기를 얻었다.
웹이 확산되면서 기능도 늘어났다. 곧 문서에 텍스트만으로는 충분치 않았다. 그렇게 이미지 지원이 추가됐다. 사람들은 문서의 생김새를 꾸미고 싶어 했고, HTML은 프레젠테이션 마크업 기능을 얻었다가 결국 CSS로 대체됐다. 동네 피자 가게의 메뉴판을 보는 것만으로는 성에 차지 않았다. 사람들은 실제로 피자를 주문하고 싶어 했고, 그렇게 등장한 세션(Session)은 쿠키(cookie)와 멱등(idempotent)하지 않은 HTTP 메서드를 낳았다. 사람들은 페이지가 상호작용하기를 원했고, 그렇게 웹은 스크립트가 가능한(scriptable) 상태가 됐다.
이 모든 기능은 ‘좋은 것’이었다. 그 덕에 웹은 실질적인 요구를 충족할 수 있었다. 하지만 이것들을 갖추게 되면서 등장한 중대한 결과는 좀처럼 자각되지 않는다.
우리에게는 더 이상 ‘문서의 웹’이 없다.
잠시 멈춰보자. 지금까지 ‘문서’라는 단어를 직관적이고 모호하게 사용했으니, 정확히 짚어볼 필요가 있겠다. 정밀한 정의는 없지만, 몇 가지 예를 들어보자. 내게 책은 문서다. 사진과 삽화가 들어간 텍스트, 과학 논문, MP3 노래, 비디오도 마찬가지다. 반면, 테트리스 게임을 즐길 수 있는 웹 페이지는 문서가 아니다. 이 구분의 본질은 문서가 조회할 때마다 변하지 않고 외부 세계의 상태에 의존하지 않는 ‘잘 정의된 콘텐츠’를 담고 있다는 점에 있다.
문서는 무상태(stateless)다. 문서는 그 자체로 존재하며, 그 자체로 하나의 소우주다. 상호작용적으로 경험될 수는 있지만, 이는 경험자가 자신의 선택에 따라 특정 부분에 주의를 기울일 수 있게 해주는 한도 내에서만 그렇다. 상호작용의 잠재적 상태는 경험자의 외부에 있는 것이지, 문서 자체의 일부가 아니다.
물론, 이는 아주 정확한 정의가 아니다. 경계선에 있는 사례가 있다. 예컨대 메뉴가 있는 영화 DVD는 문서인가? ‘모험을 선택하는’(choose-your-own-adventure) 책은 어떤가? 다른 페이지로 이동하는 하이퍼링크가 있는 HTML 페이지는? 표면적으로 보면 뒤엣것은 소우주 외부와의 상호작용을 제공하지만, 다른 각도에서 보면 책에 참고 문헌을 적어두는 것과 다르지 않다. 웹 브라우저는 단지 서가로 가서 다른 책을 꺼내오는 일을 아주 쉽게 만들어줄 뿐이다.
이 구분은 존재하며, 또한 중요하다. 이를 염두에 두고 다시 한 번 말한다.
우리에게는 더 이상 ‘문서의 웹’이 없다.
오늘날 웹은 대부분 ‘애플리케이션의 웹’이다. 애플리케이션은 더 넓은 개념이다. 텍스트나 이미지를 보여줄 수도 있지만, 애플리케이션 자체뿐 아니라 더 넓은 세상과 상호작용하게 해준다. 독자가 의식적으로 그런 상호작용이 일어나기를 의도한다면, 그건 아주 좋은 일이다.
문서는 안전하다. 책은 안전하다. 책은 우리의 손에서 폭발하지 않고, 내일 마법처럼 내용이 바뀌지도 않으며, 소지하는 게 불법이라 해도 당국에 우리를 신고하지 않는다. 우리는 문서가 문서라는 미덕 하나만으로 그것을 암묵적으로 신뢰할 수 있다. 애플리케이션은? 전혀 다르다.
특정 웹사이트를 거론하고 싶지는 않지만, 요즘 뉴스 사이트에서 하이퍼링크를 따라갔다가 기사 대신 이런 메시지와 마주하는 건 흔한 일이다.
이번 달 무료 기사를 다 읽으셨습니다. 계속하려면 등록하세요.
명백히 애플리케이션스러운 화법이다. 문서스러운 화법이 아니다. 물론 그런 웹사이트의 제공자들에게는 합당한 경제적 이해관계가 있겠지만, 일단 가입하고 나면 그들은 우리의 행동을 기록하고, 우리의 신원과 연결하고, 우리에게는 보이지 않는 ‘그림자 프로필’(shadow profile)을 구축할 수 있다. 이렇게 우리는 문서인 척 가장하는 애플리케이션을 마주하며, 실제로 그것들은 우리에게 알리지 않고 문서답지 않은 일을 감행한다.
EU의 쿠키법이나 GDPR(데이터 처리 공개를 요구하는 한도 내에서) 같은 법안이 이를 바로잡으려 노력하지만 생각하면 할수록, 문제의 뿌리에 더 가까이 접근하는 게 타당해 보인다. 문서와 애플리케이션의 개념을 분리하는 것. ‘애플리케이션의 웹’은 그대로 두고, ‘문서의 웹’을 다시 만드는 것이다. 그것과 나란히 존재하든, 또는 하위 웹으로서 존재하든.
이를 위해서는 한 걸음 물러나야 한다. (아예 처음부터 시작해 완전히 새로운 기술을 발명할 수도 있겠지만, 성공할 가능성은 낮다.) 다행히 웹이 여전히 문서의 웹이었던 1992년까지 완전히 돌아갈 필요는 없다. (나는 여전히 테이블 기반 레이아웃과 스페이서 GIF를 기억하고, 그 기억만으로도 몸서리친다.) 나는 새로운 문서의 웹이 믿음직한 HTTP(또는 더 나은 HTTPS), 그리고 오늘날 우리가 아는 HTML과 CSS에 기반을 두되, 딱 세 가지 제약만 있으면 된다고 생각한다.
- GET(그리고 아마도 HEAD) 외의 메서드 금지. POST, PUT, DELETE와 그 친구들은 문서의 웹에서 설 자리가 없다. 그것들은 멱등하지 않다. 잠재적으로 세계의 상태를 수정하는데, 문서는 그런 일을 할 수 없어야 한다. (처음엔 ‘폼(form) 금지’까지 생각했으나, 1번 규칙이 있다면 불필요한 세부 사항일 뿐이다. 어차피 GET 요청으로 변환되는 폼은 URL 생성을 도울 뿐이고, 사용자가 결과 URL을 직접 타이핑하는 것과 다를 바가 없는 까닭이다.)
- 모든 종류의 스크립트 금지. 자바스크립트도, 웹어셈블리(WebAssembly)도 안 된다. 코드 조각에 구문 강조(syntax-highlight)를 하는 등 문서를 풍부하게 만드는 용도로도 안 된다. 너무 엄격해 보일 수 있지만, 안전한 편에 서는 것이 낫고 강제하기도 매우 쉽다.
- 쿠키 금지. 쿠키 자체는 상호작용적이지 않지만, 쿠키가 있으면 HTTP의 의미론을 악용해 세션을 재생성하기가 너무 쉬워진다. 그 위에 다시 ‘앱 바퀴’(app-wheel)를 재발명하게 될 것이고, 결국 문서의 웹을 다시 잃게 될 가능성이 크다.
내가 놓친 예외 상황이 있을 수도 있다. 하지만 웹 페이지가 이 제약을 준수한다면, 그것을 ‘문서’라 부르고 ‘문서의 웹’의 일부로 편입시키는 건 꽤 안전하다.
이걸 어떻게 달성할까? 사실 잘 모르겠다. 구체적인 제안은 없다. 문서의 웹을 위한 전용 웹 브라우저를 만들 수도 있고, 기존 웹 브라우저가 사용자에게 지금 열람하는 게 문서인지 애플리케이션인지 눈에 띄게 알려주도록 만들 수도 있을 것이다. 기술적인 결정 외에도, 이 아이디어가 이륙하려면 상당한 캠페인과 로비가 필요하다.
이 아이디어가 실현되리라고 감히 꿈꾸지는 않는다. 이 글의 의도는 일단 생각할 거리를 던지는 데 있다. 독자에게 바라는 건 오직 고려와 관심뿐이다. 독자가 여기까지 읽었다면, 아마도 나는 그것을 얻은 셈이다.
이 웹 페이지는 문서다. 그저 감사드릴 따름이다.